A Microsoft atribuiu a interrupção global do Microsoft 365 na semana passada a uma atualização de julho em seus servidores de gateway de rede. A vulnerabilidade ficou inativa por mais de três meses antes que picos de carga e quedas de capacidade a desencadeassem, de acordo com o relatório postmortem preliminar da empresa.
A Microsoft divulgou o relatório aos clientes no Centro de Administração do Microsoft 365 em 15 de novembro de De acordo com o Cadastro. Charles Lamanna, vice-presidente executivo de Copilot, agentes e plataformas da Microsoft, postou uma versão resumida no X na segunda-feira, Relatórios ZDNET.
“Uma falha potencial faz com que os servidores fiquem sobrecarregados e parem de responder sob certas condições de carga”, escreveu LaManna.
Faça três coisas ao mesmo tempo
A atualização de julho foi criada especificamente para o Microsoft 365 Network Gateway Server. A Microsoft disse que passou nos testes de carga e funcionou sem problemas em todo o mundo. Mas a falha causou contenção de bloqueio em um processo interno do Windows, que consumiu CPU e memória do servidor.
O relatório disse que os testes falharam porque os testes de carga ocorreram principalmente em hardware mais fraco com menos núcleos. Esta disputa é mais severa em máquinas mais novas com mais núcleos.
Então duas outras condições são atendidas. As equipes fizeram failover para um gateway que também hospeda o Exchange Online, o que aumentou a carga. Enquanto isso, um problema não relacionado ocorrido no dia anterior tirou quase 14% da capacidade do servidor gateway fora de serviço.
Quando um servidor para de responder, o tráfego é movido para o próximo servidor íntegro, que apresenta o mesmo erro. O relatório disse que em duas horas, mais de 80% dos servidores não responderam no ponto mais baixo.
Por que a recuperação demora tanto?
Assim que o servidor voltar a ficar online, a espera pelo tráfego pode sobrecarregar o servidor novamente. A Microsoft disse que sua recuperação automática não foi projetada para uma gama tão ampla de falhas.
“Como a falha primária no código era um bug latente de vários meses atrás, nossas reversões, voos e sinalizadores de recursos normais não foram capazes de reverter rapidamente as alterações”, escreveu LaManna.
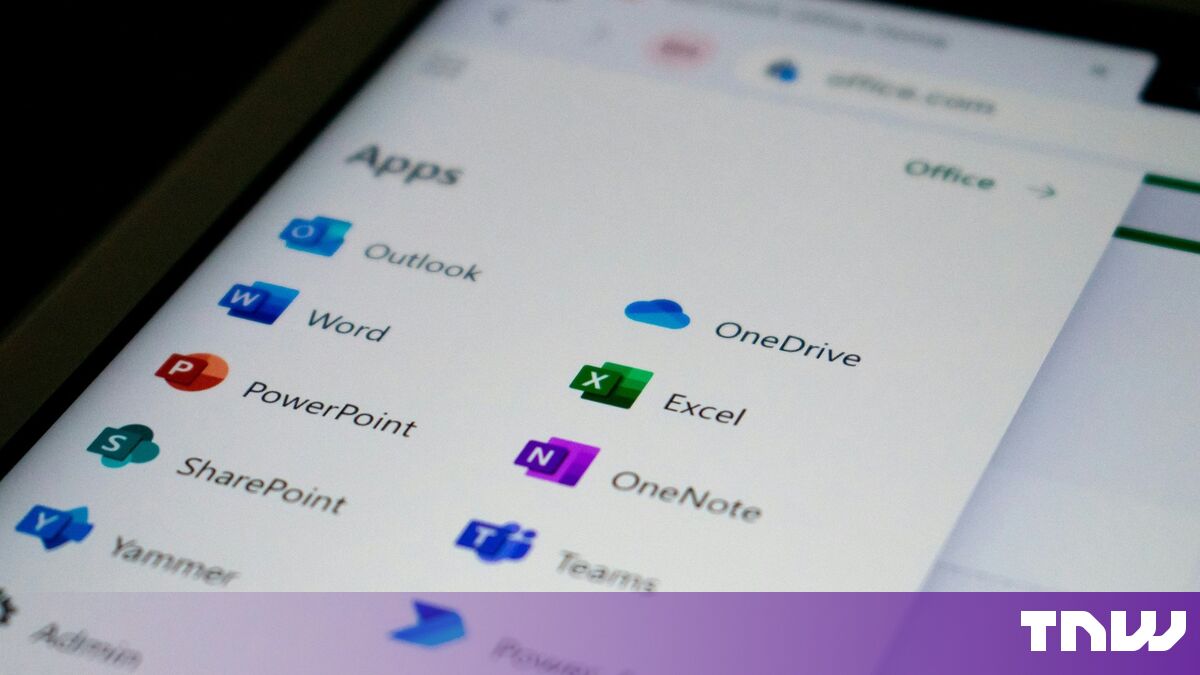
Em vez disso, os engenheiros escreveram uma atualização que retornou o caminho do código do Windows ao seu estado anterior. Eles, por sua vez, aplicam-no ao grupo de servidores. Os aplicativos Teams, OneDrive, SharePoint e Office podem ser movidos de gateways com falha e restaurados mais rapidamente. O Exchange Online não pode fazer isso por motivos de escala, e é por isso que o Outlook está inativo há mais tempo.
O cronograma do relatório publicado pelo The Register começa com o failover do Teams em 12 de novembro às 01h07 UTC. O primeiro caso de suporte foi recebido às 16h33 UTC. A Microsoft começou a aplicar a correção em 13 de novembro às 07h20 UTC e enviou uma atualização ao cliente final em 14 de novembro às 04h15 UTC.
Mais de 1.000 engenheiros e outros funcionários aderiram à chamada de interrupção, liderados por Lamanna e pelo chefe da nuvem, Scott Guthrie. Relatórios Bloomberg. Em 13 de novembro, a Microsoft pediu desculpas e disse que a causa não foi um ataque cibernético ou um agente de inteligência artificial.
Pedimos desculpas profundamente pela interrupção que este incidente causou aos nossos clientes e parceiros. Sabemos da confiança que depositam nos nossos serviços e levamos esta responsabilidade muito a sério. Estamos vendo uma recuperação e estabilização generalizadas em nossos serviços.
Esta é uma questão técnica que não tem nada a ver com redes ou IA/agentes. O incidente foi causado por problemas durante uma atualização inicial da capacidade da rede que surgiu após mudanças recentes na rede. Resolvemos o problema subjacente e continuamos a restaurar o serviço para os clientes e regiões restantes.
Dada a dimensão da procura, estamos a restaurar gradualmente os serviços, verificando a estabilidade em cada etapa. Embora demore mais, ajuda a garantir uma recuperação estável.
Assim que a revisão for concluída, forneceremos um relatório pós-incidente completo.
-Microsoft (@Microsoft) 13 de novembro de 2026
problema de Washington
A interrupção afetou governos, tribunais, hospitais e empresas. DownDetector registra relatórios de 74 países e regiões Imprensa Associada. A TNW informa sobre a restauração dos serviços e o subsequente debate sobre a soberania europeia.
No mês passado, os serviços do Google Cloud foram interrompidos na área de Londres, afetando serviços como o Revolut.
O presidente do Comitê de Segurança Interna da Câmara, Andrew Garbarino, disse Político Ele está buscando mais informações da Microsoft e da CISA.
“Precisamos entender o que está acontecendo e como tornar esses sistemas mais resilientes”, disse Garbarino.
De acordo com o The Register, a Microsoft planeja divulgar um relatório final pós-incidente em 20 de novembro.