Os entusiastas da IA podem gastar uma quantidade excessiva de tempo tentando fazer com que um modelo faça algo diferente daquilo para o qual foi projetado. Forneça-lhe uma coleção de documentos privados. Dê a ele uma base de código e veja se ele entende a convenção. Ajuste o modelo aberto, altere os dados, execute-o novamente e compare os resultados. Depois que um experimento é bem-sucedido, a próxima pergunta geralmente surge rapidamente: o modelo pode fazer a maior parte do trabalho, talvez agindo como um agente que pode usar ferramentas e concluir várias etapas sem ser solicitado todas as vezes?
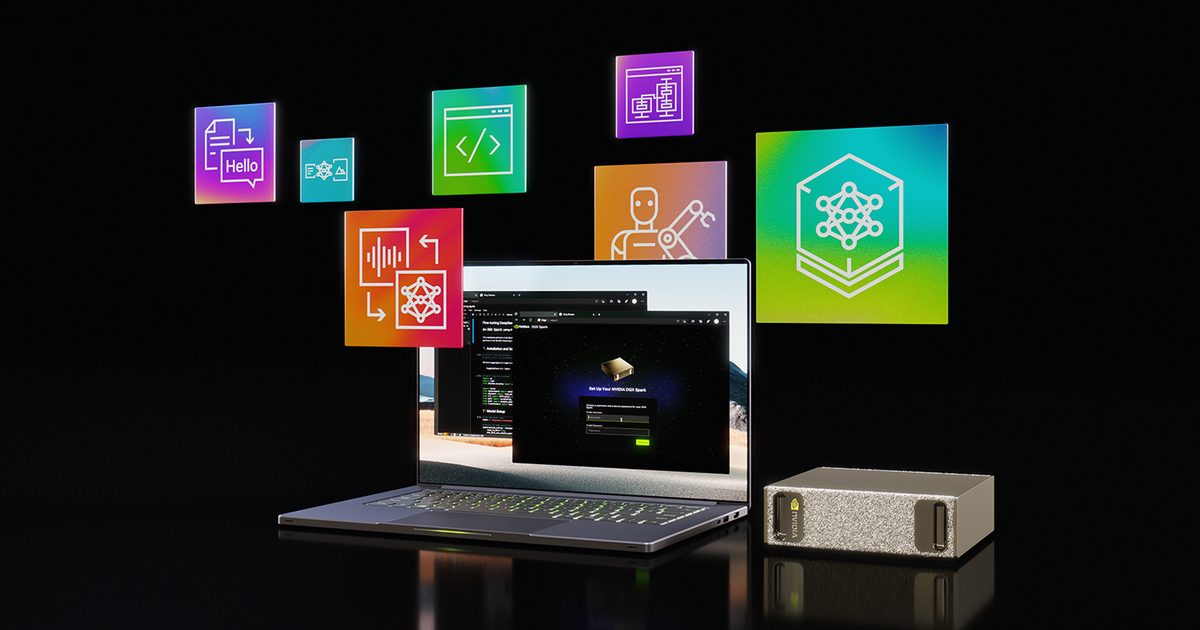
NVIDIA DGX SparkMT Os 64 GB, disponíveis exclusivamente nos parceiros OEM Acer, Asus, Dell, Gigabyte, HP e MSI, foram desenvolvidos para esse tipo de ajuste. O sistema de desktop compacto combina um superchip NVIDIA GB10 Grace Blackwell com 64 GB de memória unificada coerente e a pilha de software de IA da empresa para criar uma plataforma nativa para ajuste fino de modelo, inferência e agentes de IA autônomos. Ele vem com rede ConnectX-7 integrada que pode ser dimensionada para vários clusters Spark à medida que as cargas de trabalho aumentam. A NVIDIA direciona a configuração de 64 GB para desenvolvedores, pesquisadores, estudantes, cientistas de dados e entusiastas de IA que desejam construir com modelos locais em vez de simplesmente acessá-los por meio de um serviço em nuvem.
Um desktop tradicional pode lidar com um grande número de experimentos de IA até que os experimentos se tornem mais ambiciosos. Executar um modelo é relativamente simples; manter o modelo maior, seu contexto e as partes de suporte do aplicativo disponíveis ao mesmo tempo é outra. DGX Spark aborda esse problema de outra direção, colocando a computação e a memória de IA no centro do design, em vez de tratar a IA nativa como algo que um PC de uso geral simplesmente suporta.
A parte divertida começa quando o modelo se torna seu
Quando os modelos não são mais vistos como produtos acabados, a IA local torna-se mais útil. Por exemplo, um desenvolvedor que está construindo um assistente de codificação pode não querer um modelo geral que saiba apenas programar. O ajuste fino de um modelo existente para uma base de código específica pode criar um ponto de partida muito diferente para experimentos futuros, especialmente quando os desenvolvedores desejam testar até que ponto o modelo entende como o software é realmente escrito.
A NVIDIA identificou esse fluxo de trabalho especificamente para DGX Spark. Os desenvolvedores podem ajustar os LLMs existentes usando seu próprio código-fonte de software e, em seguida, executar os modelos resultantes localmente para futuras tarefas de desenvolvimento. A mesma configuração também pode oferecer suporte a projetos de visão computacional, testes de inferência local e trabalho de ciência de dados, dando aos desenvolvedores espaço para passar do treinamento e experimentação para o teste sem mover imediatamente as cargas de trabalho para outro lugar.
O hardware torna-se parte do ciclo criativo à medida que a distância entre a ideia e o teste diminui. Os desenvolvedores podem alterar o modelo, executá-lo localmente, verificar os resultados e tentar novamente sem enviar cada iteração para um serviço de inferência externo. Portanto, em vez de simplesmente manter o modelo offline, a computação local dá o controle direto do experimento às pessoas que constroem o modelo.
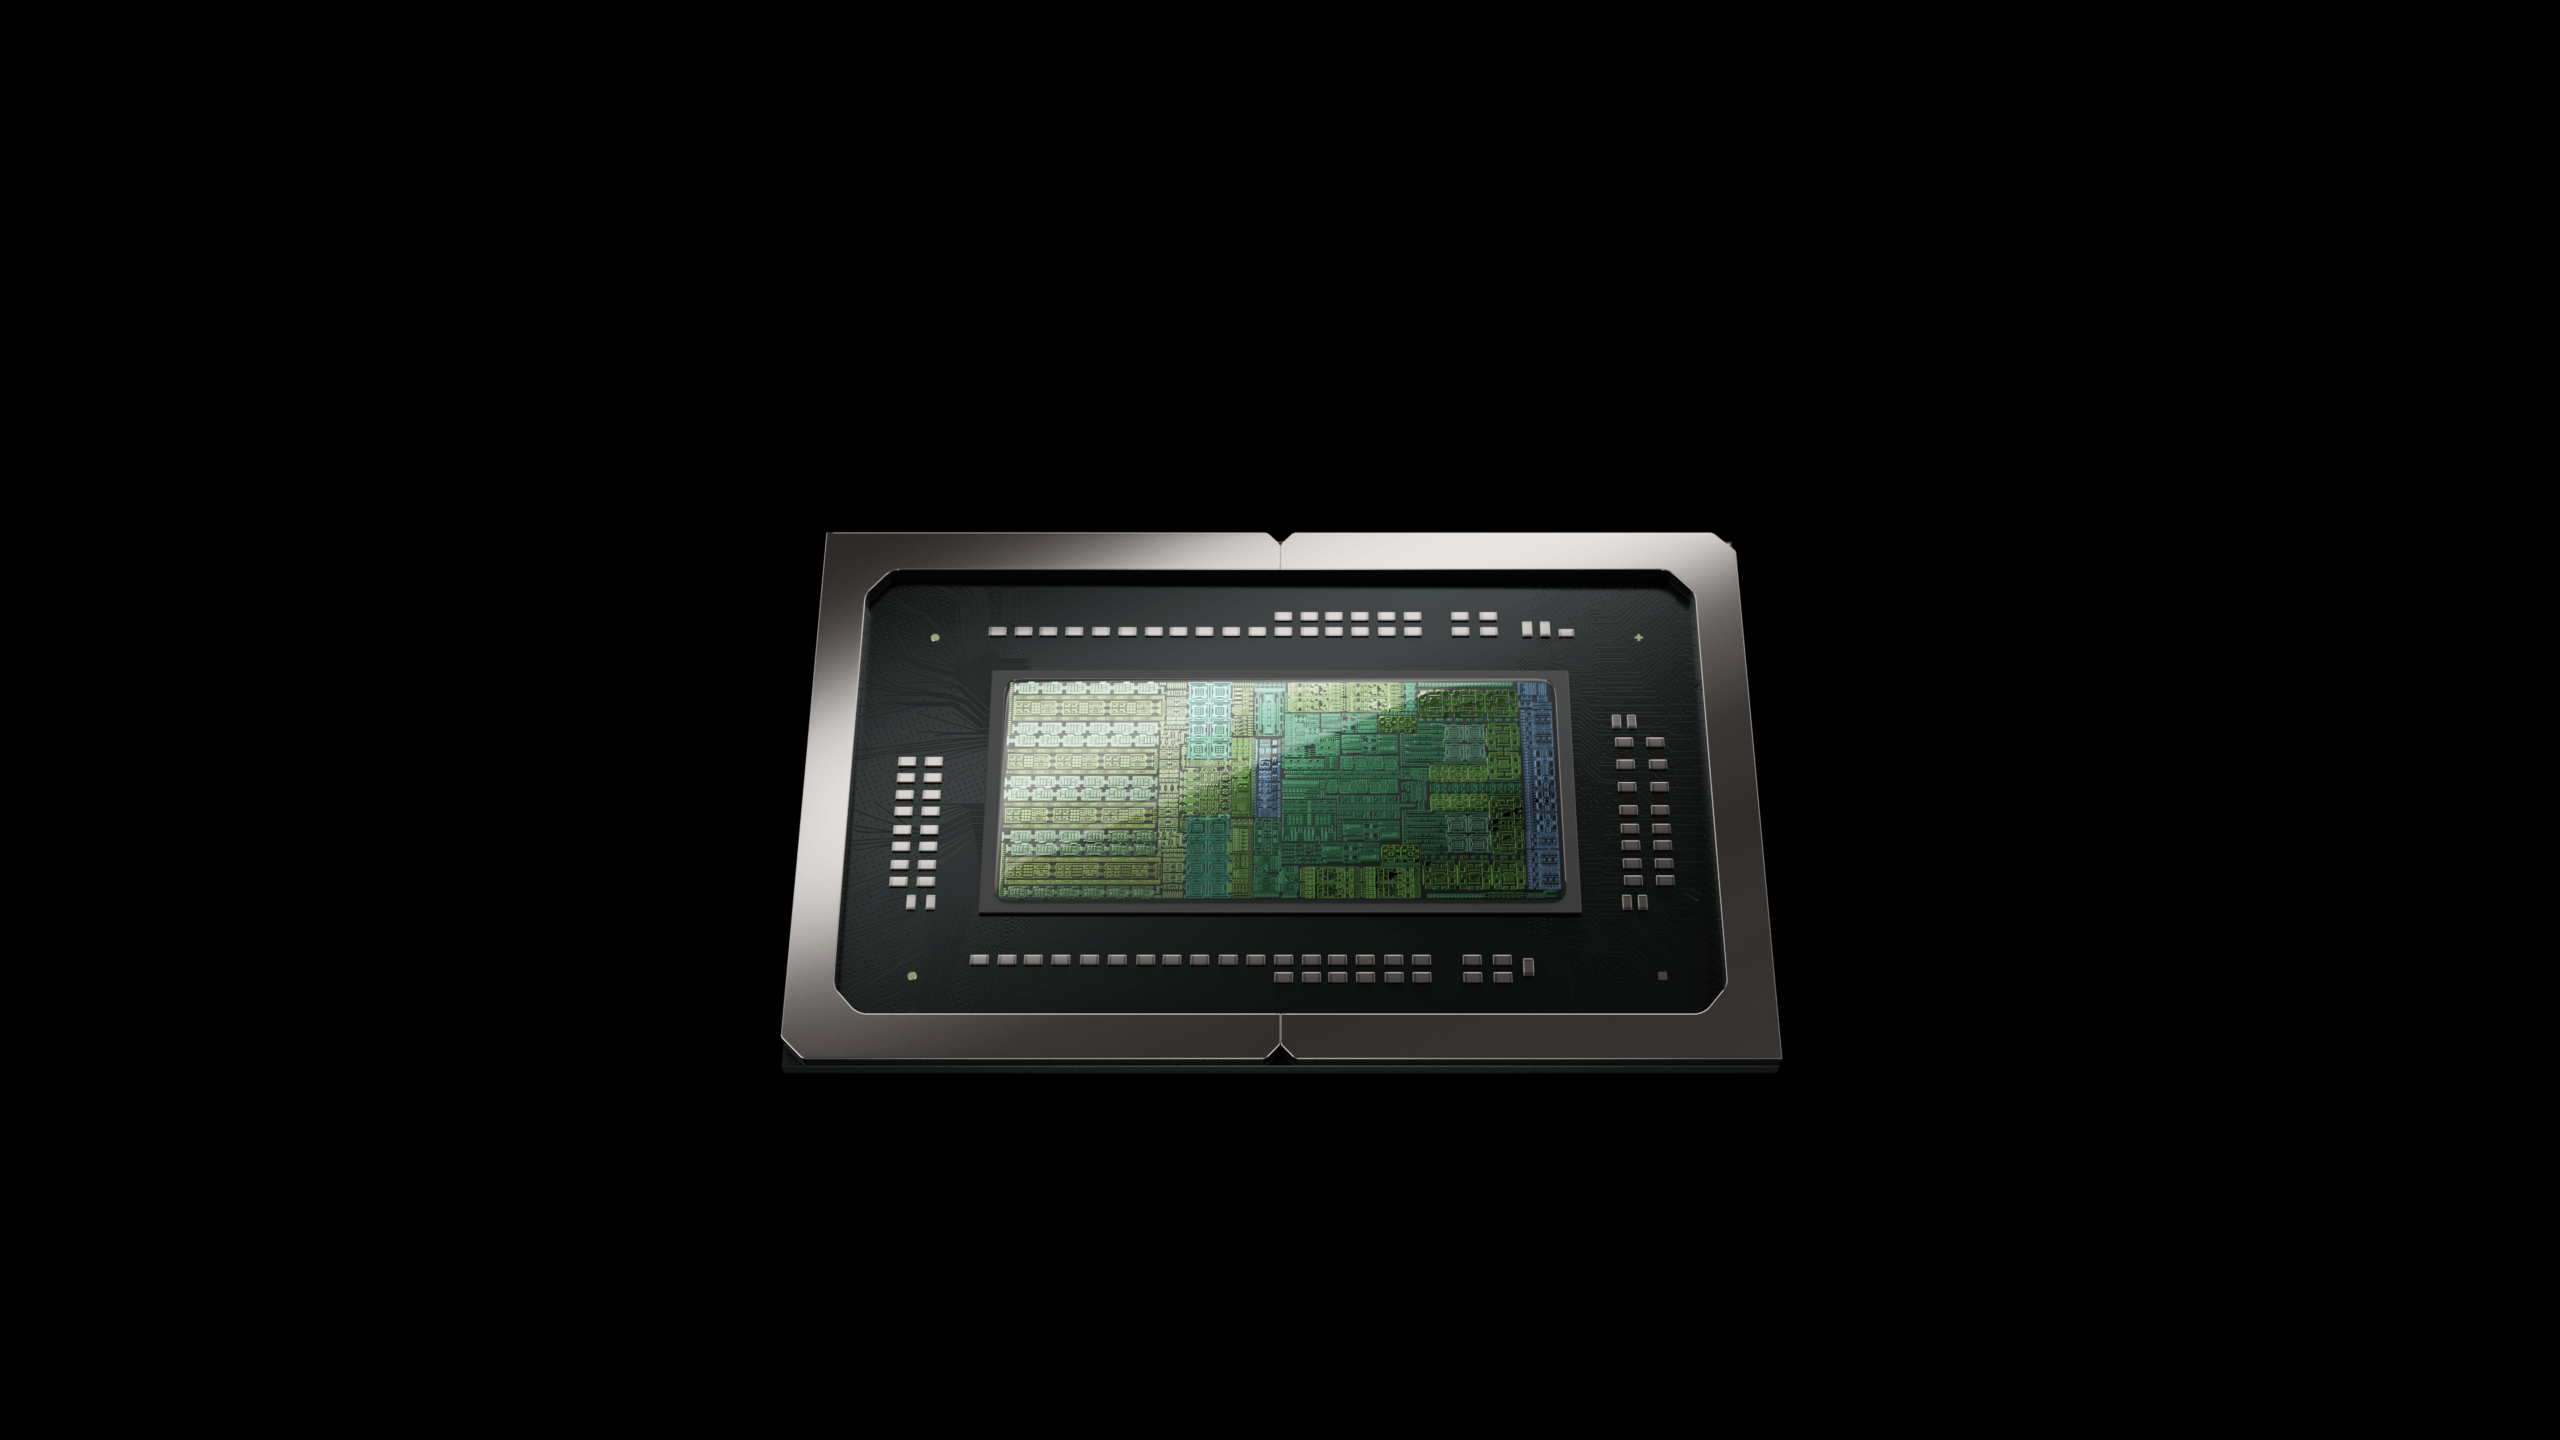
O DGX Spark 64GB foi projetado em torno desse fluxo de trabalho. O GB10 Grace Blackwell Superchip combina uma GPU Blackwell com uma CPU Arm de 20 núcleos, e o NVLink-C2C cria uma arquitetura de memória consistente que permite que o processador e a GPU trabalhem no mesmo pool de memória. A NVIDIA avalia o desempenho do sistema FP4 AI em até 1 petaFLOP e largura de banda de memória de 273 GB/s.
Quando os experimentos ficam maiores, as máquinas ficam interessantes
A memória é facilmente esquecida quando se fala em hardware de IA, já que as GPUs geralmente chegam às manchetes. Os modelos locais tornam a memória mais difícil de ignorar. O modelo precisa de espaço para ser executado, mas o mesmo acontece com contextos mais longos, modelos adicionais e outras partes do aplicativo construído em torno dele. Máquinas que podem lidar facilmente com um modelo podem se tornar menos confortáveis quando as cargas de trabalho começarem a se comportar como aplicações reais.
A NVIDIA visa configurações de 64 GB com modelos abertos mais recentes, incluindo Qwen3.8-27B, Meta Muse Glimmer e NVIDIA Nemotron 3.5 Lightning. A empresa descreve esses modelos como oferecendo recursos comparáveis aos modelos de última geração de apenas alguns meses atrás, enquanto ocupam 64 GB de RAM. Usando a rede CX-7 e o NVIDIA Sync Cluster Assistant, dois sistemas de 64 GB podem ser agrupados perfeitamente para agrupar 128 GB de memória e executar modelos maiores e cargas de trabalho maiores.
Os benefícios dessa capacidade vão além de poder apontar um número maior em uma ficha técnica. Mais memória dá aos entusiastas espaço para manter contextos mais ricos disponíveis, executar cargas de trabalho de suporte junto com modelos e experimentar aplicativos nativos cada vez mais complexos antes que o próprio hardware se torne o fator limitante.
A NVIDIA também está tentando remover alguns dos atritos que geralmente acompanham as configurações locais de IA. DGX Spark executa o sistema operacional DGX e vem com a pilha de software de IA acelerada por NVIDIA CUDA, incluindo PyTorch, Jupyter e Ollama para prototipagem, ajuste fino e inferência.
Dê um trabalho à IA, o hardware tem mais a provar
Agentes autônomos mudam a natureza dos experimentos porque não se espera mais que o modelo produza uma resposta e pare. Um agente de codificação pode revisar o projeto, identificar problemas, fazer alterações, testar os resultados e prosseguir com base no que foi aprendido. Os fluxos de trabalho de pesquisa podem envolver vários modelos especializados, chamadas de ferramentas e uma grande quantidade de contexto que precisa ser mantido disponível à medida que a tarefa avança.
O DGX Spark foi projetado para essas cargas de trabalho, onde vários modelos e agentes podem compartilhar o mesmo grande conjunto de memória. A NVIDIA descreve especificamente o sistema como uma plataforma para inferência de contexto longo, pipelines multiagentes e inferência local, enquanto o NVIDIA OpenShellMT Forneça controles de privacidade e segurança baseados em políticas para cargas de trabalho de proxy.
Os amadores não precisam construir grandes sistemas multiagentes para usar o hardware. Um primeiro projeto mais razoável poderia ser um agente que possa processar conjuntos de dados pessoais, inspecionar projetos de software, organizar informações ou lidar com sequências de tarefas repetitivas. A computação local facilita a iteração desses experimentos porque a pessoa que cria o fluxo de trabalho controla o modelo, os dados e o ambiente em que tudo é executado.
Os serviços em nuvem ainda desempenham um papel claro quando os projetos exigem computação pesada. O hardware local muda a equação dos experimentos conduzidos antes do projeto atingir essa escala, especialmente quando cada solicitação de inferência adicional adiciona outro custo de uso. A NVIDIA posiciona o DGX Spark como uma forma de manter modelos, dicas, dados e inferência no dispositivo sem pagar taxas por token para inferência na nuvem.
O segundo Spark muda seu posicionamento na área de trabalho
Um projeto que começa com uma máquina não precisa necessariamente permanecer nela. A NVIDIA incorporou redes no DGX Spark para que, à medida que as cargas de trabalho aumentam, outros sistemas possam se tornar parte do mesmo ambiente local de IA.
Dois sistemas DGX Spark de 64 GB podem ser conectados para criar um pool de memória de 128 GB e até 2 PFLOPS de potência total de computação de IA. A NVIDIA afirma que o par pode oferecer até 1,7x o desempenho de um sistema DGX Spark de 128 GB na configuração descrita em sua introdução. O ConnectX-7 fornece interconexão de alta velocidade, enquanto o NVIDIA Sync descobre sistemas e ajuda a configurar clusters por meio do Cluster Assistant.
Configurações maiores ampliam ainda mais essa ideia. A NVIDIA descreve clusters de até quatro sistemas DGX Spark, criando um pool maior de memória compartilhada para modelos e cargas de trabalho que excedem a capacidade de uma única unidade. Seu material técnico também descreve inferência distribuída e cargas de trabalho de ajuste fino projetadas para escalar em vários sistemas.
NVIDIA Sync é muito útil aqui porque pode ficar em segundo plano. O software pode descobrir sistemas conectados, configurar redes, rotear cargas de trabalho e monitorar a integridade do sistema, permitindo que os desenvolvedores se concentrem em projetos de IA em vez de transformar a configuração do cluster em um projeto separado.
O laboratório de IA fica pequeno o suficiente para caber em uma mesa
O design físico torna a proposta ainda mais inusitada. O DGX Spark mede 150 mm x 150 mm x 50,5 mm e pesa 1,2 kg, mas o hardware foi projetado para cargas de trabalho que envolvem modelos grandes, inferência local e agentes autônomos. A NVIDIA também descreve o sistema como eficiente em termos energéticos o suficiente para funcionar a partir de uma tomada de parede padrão, tornando-o útil para cargas de trabalho que precisam permanecer ativas em vez de apenas inicializar quando alguém está sentado na estação de trabalho.
O DGX Spark 128 GB continuará disponível através da NVIDIA e de todos os parceiros OEM para usuários que necessitam de mais memória, com outra configuração disponível para a plataforma à medida que as cargas de trabalho locais aumentam. No entanto, para aqueles que desejam experimentar IA nativa usando modelos pequenos e de código aberto de última geração, o modelo de 64 GB é um ponto de partida mais interessante.
O que é interessante em trazer tanto poder de IA para a mesa é o que ela faz como ponto de partida para experimentação. Os desenvolvedores não precisam decidir desde o início qual serviço de nuvem usar ou quanto tempo de computação um projeto deve ter. Modelos, dados e ferramentas estão ao seu alcance, tornando mais fácil continuar refinando uma ideia até que ela se torne algo útil.
O DGX Spark 64GB foi projetado exatamente para esse tipo de trabalho. Sua combinação de computação Grace Blackwell, 64 GB de memória unificada e pilha de software de IA nativa da NVIDIA oferece aos desenvolvedores e entusiastas de IA o espaço para trabalhar em modelos maiores, ajustá-los, criar agentes e testar resultados localmente. Quando um projeto eventualmente requer mais memória ou computação, sistemas DGX Spark adicionais podem dimensionar a mesma configuração em vez de forçar um fluxo de trabalho totalmente diferente.
A NVIDIA lançou hoje (2 de outubro de 2026) o DGX Spark 64GB, e o sistema estará disponível nos parceiros OEM da NVIDIA em 23 de outubro. Para quem está experimentando modelos locais e se perguntando até que ponto mais memória e computação de IA dedicada poderiam fazer isso funcionar, é aqui que os experimentos ficam interessantes. A questão não é mais apenas qual modelo tentar em seguida. Assim que o hardware fornecer espaço suficiente para continuar promovendo a ideia, você poderá construí-la.