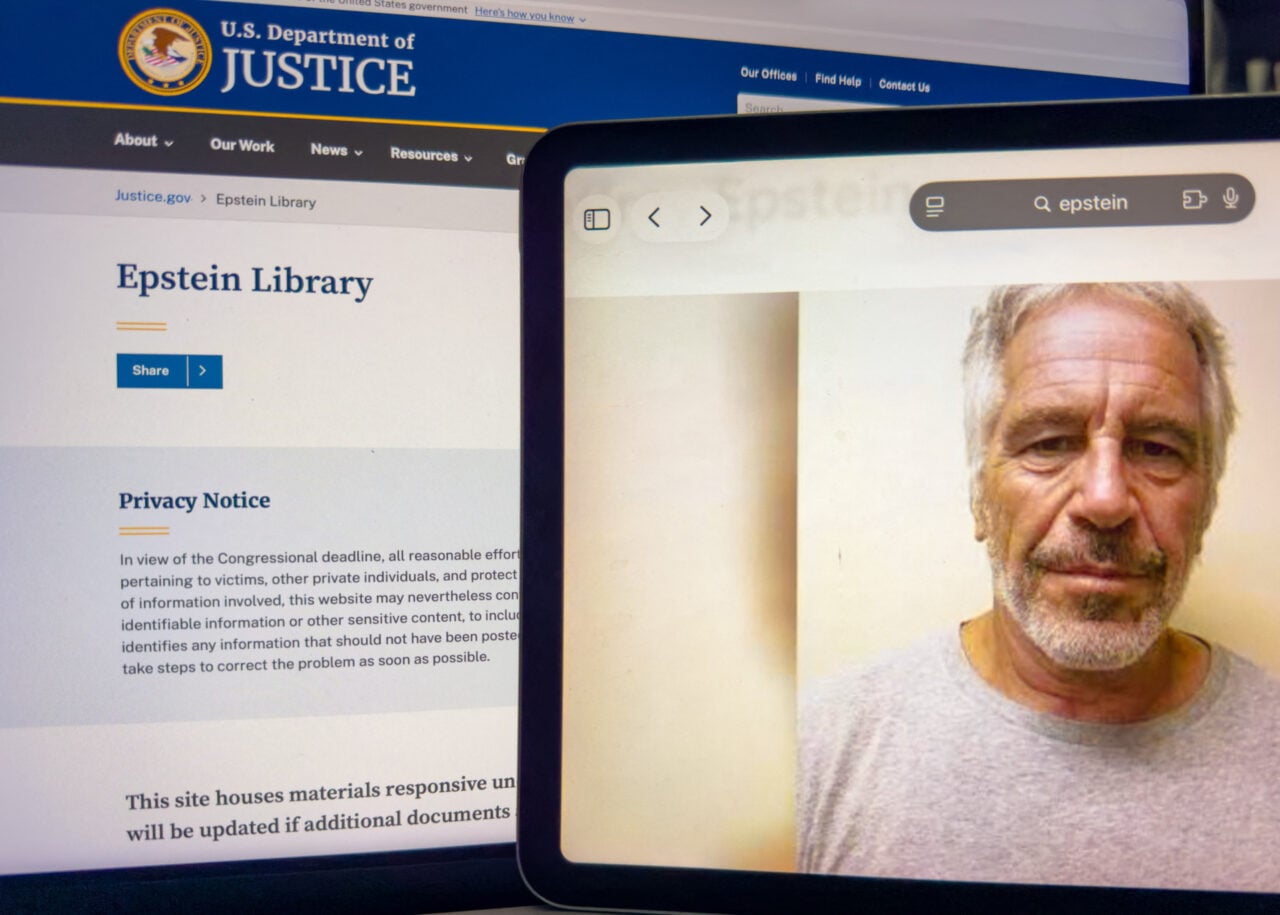
A vítima de Jeffrey Epstein entrou com uma ação coletiva na quinta-feira contra o Google, alegando que o método de IA da empresa vazou informações pessoais sobre as vítimas do traficante sexual.
Por causa disso ação legalO Departamento de Justiça começou a divulgar mais de 3 milhões de páginas de evidências por conta própria caso contra Epifânio em lotes no final do ano passado e no início deste ano. No entanto, o volume de comentários é considerado problemático com os nomes de alguns dos predadores reduzido enquanto algumas das identidades dos restos mortais foram redigidas indevidamente.
“Os cidadãos dos Estados Unidos agindo através do DOJ fizeram uma escolha deliberada de fazer uma divulgação rápida e em grande volume sobre a proteção dos restos secretos da Epifania”, de acordo com causa arquivado no Tribunal Distrital dos EUA para o Distrito Norte da Califórnia. A ação alega que os sobreviventes não só tiveram que conviver com o trauma, mas também foram vítimas de assédio quando suas informações foram publicadas.
Embora o DOJ tenha posteriormente removido os erros, as informações foram mantidas online por meio da função de pesquisa de IA do Google, AI Mode, afirma o demandante.
“Mesmo depois de o governo ter reconhecido que a divulgação violava os direitos dos sobreviventes e retirado a informação, entidades online como o Google continuam a protestar, recusando-se a retirar os apelos da vítima”, diz o processo.
Com o nome da demandante, que atende por “Jane Doe”, bem como os nomes de outras vítimas representadas neste processo, o Google AI Mode reivindica seu “nome completo, informações de contato, cidades de residência e associação com Jeffrey Epstein”. No caso do demandante, a IA também “gerou um link de hipertexto que permite a alguém enviar um e-mail direto ao reclamante com o clique de um botão”.
O processo afirma que a vítima notificou o Google sobre o problema em diversas ocasiões ao longo de dois meses, sem sucesso.
“Apesar da notificação real das violações, dos danos substanciais através da disseminação contínua e do status de vários membros da classe, como sobreviventes de abuso sexual, que estão sujeitos a proteções de privacidade aprimoradas sob a lei, o Google ignorou e se recusa a remover, retirar da lista ou bloquear o acesso aos materiais ofensivos”, afirma o processo. “Notavelmente, várias outras ferramentas de IA disponíveis publicamente que são usadas para analisar o conteúdo de fontes online, como ChatGPT, Close e Complexity, não forneceram informações relevantes em testes repetidos semelhantes.”
Ao contrário da pesquisa do Google, o método de IA “não é um índice de pesquisa neutro, mas um autor ativo e gerador de conteúdo”, argumenta o processo, e pode ser chamado de “atividade doxxing”.
O caso surge no final da semana, quando foi testada a responsabilidade legal da gigante tecnológica pelos conteúdos online. Meta e Google foram considerados culpados em um julgamento de dependência de mídia social em Los Angeles na quarta-feira, e Meta foi considerado culpado em um julgamento de segurança infantil online no Novo México na terça-feira.
Ambos os processos foram considerados casos marcantes que podem se transformar em momentos decisivos na forma como a liberdade de expressão é regulamentada online nos Estados Unidos. Atualmente, ao abrigo da secção 230 da Lei de Decência nas Comunicações, grandes gigantes da tecnologia como a Google, que operam estas plataformas online, estão isentos de qualquer responsabilidade por conteúdos publicados por terceiros. Com as decisões desta semana contra Meta e Google, as proteções da Seção 230 dos gigantes da tecnologia estão agora sendo seriamente desafiadas.
A seção 230 era aplicável ao tema IA contenção. O senador Ron Wyden, que ajudou a redigir a lei, disse ao Gizmodo em janeiro que os gatos da IA não estão protegidos contra ela.
O Departamento de Justiça e o Google não responderam imediatamente ao pedido de comentários do Gizmodo.