A partir de 1º de janeiro, qualquer pipeline de auditoria que chame Perspectiva falhará. A unidade Jigsaw do Google encerrou o serviço em 31 de dezembro, encerrando uma das ferramentas de pontuação de toxicidade de análises online mais utilizadas. Os próximos meses trarão uma decisão impopular para a plataforma, editores, mercados e comunidades construídas sobre ela. Encontre um substituto e rápido.
A retrospectiva espera ser esse substituto. Mas em vez de propor uma troca padrão de fornecedores, está oferecendo algo que nenhum fornecedor de moderação de conteúdo de IA ofereceu antes: garantias profissionais contra danos causados por conteúdo perdido por seus modelos.
“A linguagem de codificação é o novo insulto, mas é muito difícil de capturar de forma consistente”, disse Dean Gebert, fundador da Hindsight. “Um modelo semelhante ou troca de ferramentas simplesmente mudaria os pontos cegos da Perspective para um fornecedor diferente.”
A migração forçada funciona como auditoria empresarial
A maioria das empresas consideraria o fechamento da Perspective como uma tarefa rotineira de engenharia. Em retrospectiva, esta é uma oportunidade para fazer perguntas mais difíceis: as ferramentas antigas forneciam proteção precisa em primeiro lugar?
As opiniões avaliam o quão tóxico é um comentário”som” Aceite isso pelo valor de face. Isso funciona bem para insultos óbvios. Não funciona bem para uma linguagem projetada para parecer inofensiva.
Os bandidos sabem disso, e é por isso que recorrem à linguagem codificada: códigos numéricos como “1488.“Gíria extremista como”Bugaboo,” troca de caracteres (conhecidos como “l33tspe@k”) e erros ortográficos que imitam fala com fio, como “Fago“. Custos e responsabilidades são mostrados em fóruns, postagens, comentários, perfis, DMs, materiais impressos, etc.
E não se limita apenas ao inglês. Até mesmo a plataforma exclusiva dos EUA tem postagens em espanhol e dezenas de outros idiomas, então a linguagem codificada se espalha com ela. O Hindsight é pré-treinado para 110 idiomas, o que significa que pode seguir a linguagem de codificação em todos os idiomas sem precisar construir modelos separados para cada idioma.
As apostas são reais. De 2016 a meados de 2022, a Liga Antidifamação descobriu que os extremistas arrecadaram pelo menos 6,2 milhões de dólares através de 324 campanhas de crowdfunding. Além disso, mais de 30 processos federais foram movidos contra uma grande plataforma de jogos, alegando que suas proteções não atendiam às necessidades dos usuários jovens. Finalmente, mercadorias com mensagens nacionalistas brancas continuam a aparecer nos principais mercados online.
Por trás de cada um deles existe um sistema de auditoria que deve funcionar. O fechamento da perspectiva cria uma oportunidade para repensar.
Por que os modelos binários são forçados a se comprometer
Muitas ferramentas de auditoria dependem de uma lógica binária estrita: segura ou insegura. Isso cria uma situação de perda ou perda para os executivos da plataforma. Se o sistema fosse ajustado para ser mais rígido, os revisores humanos gerariam um grande número de falsos positivos para as gírias do dia a dia. Ajuste-o para ficar solto e ele perderá o conteúdo que cria responsabilidade.
As três categorias de retrospectiva: bandeiras vermelhas, bandeiras amarelas e segurança, criam um meio-termo para uma linguagem vaga e dependente do contexto. A automação elimina os casos fáceis, permitindo que revisores humanos gastem seu tempo em casos extremos mais difíceis (o que se resume ao ajuste fino da instância do cliente).
Gebert reconhece que essas conversas podem ser desconfortáveis, então seu “exemplo mais seguroA palavra “vadia” pode ser depreciativa ou adoradora dependendo do contexto. Para uma pessoa irritada (quem diabos é essa vadia?), isso é uma clara bandeira vermelha. Entre amigos (ela é a vadia mais malvada que conheço), provavelmente é seguro. Mas o modelo binário ainda não consegue distingui-los.
“É uma chatice sempre classificar o texto contextual na categoria exata da bandeira amarela,“Gebert ri. “É preciso doses iguais de obsessão, teimosia e um café com leite. Mas valerá a pena, pois os clientes confiarão menos na supervisão humana e obterão resultados mais precisos. “
O que o benchmark mostra
A Hindsight comparou 9 modelos de moderação de conteúdo de IA (Mistral, OpenAI, Meta, Azure, AWS, etc.) com um conjunto fixo de 2.205 postagens online reais. Uma pessoa marca cada postagem como bandeira vermelha, bandeira amarela ou segura e, em retrospectiva, a variante do modelo nunca viu nenhuma postagem durante o desenvolvimento ou treinamento.
Quando se trata de linguagens de codificação, a Hindsight encontrou 97,9% dos casos. Outros modelos pontuaram 65% ou menos. Sua taxa de bandeira falsa é de 3,3% e sua taxa de alarme falso é de 8,2%. A empresa publica metodologia e resultados completos de benchmark seu sitea empresa tem a capacidade Testando retrospectivamente com seus dados.
Eficiência especializada: Sniper vs. Shotgun
Os resultados desafiam diretamente a suposição de que modelos maiores sempre apresentam melhor desempenho. Em retrospectiva, não usando um grande modelo de base comum. Ele é construído sobre três modelos básicos especializados, cada um com menos de 600 milhões de parâmetros, e a empresa afirma que os resultados são melhores do que modelos 14 vezes maiores. Gerbert o descreveu mais como um rifle de precisão do que como uma espingarda.
Seus dados de treinamento são intencionalmente restritos, consistindo em 83 MB de postagens on-line reais de 18 conjuntos de dados (aproximadamente 37 livros de Harry Potter), incluindo 292 mil postagens sinalizadas por revisores humanos. Das 164 variantes treinadas, a empresa acompanha o desempenho de cada variante e promove a melhor variante como vencedora.
O que aconteceu com a garantia de US$ 1 milhão?
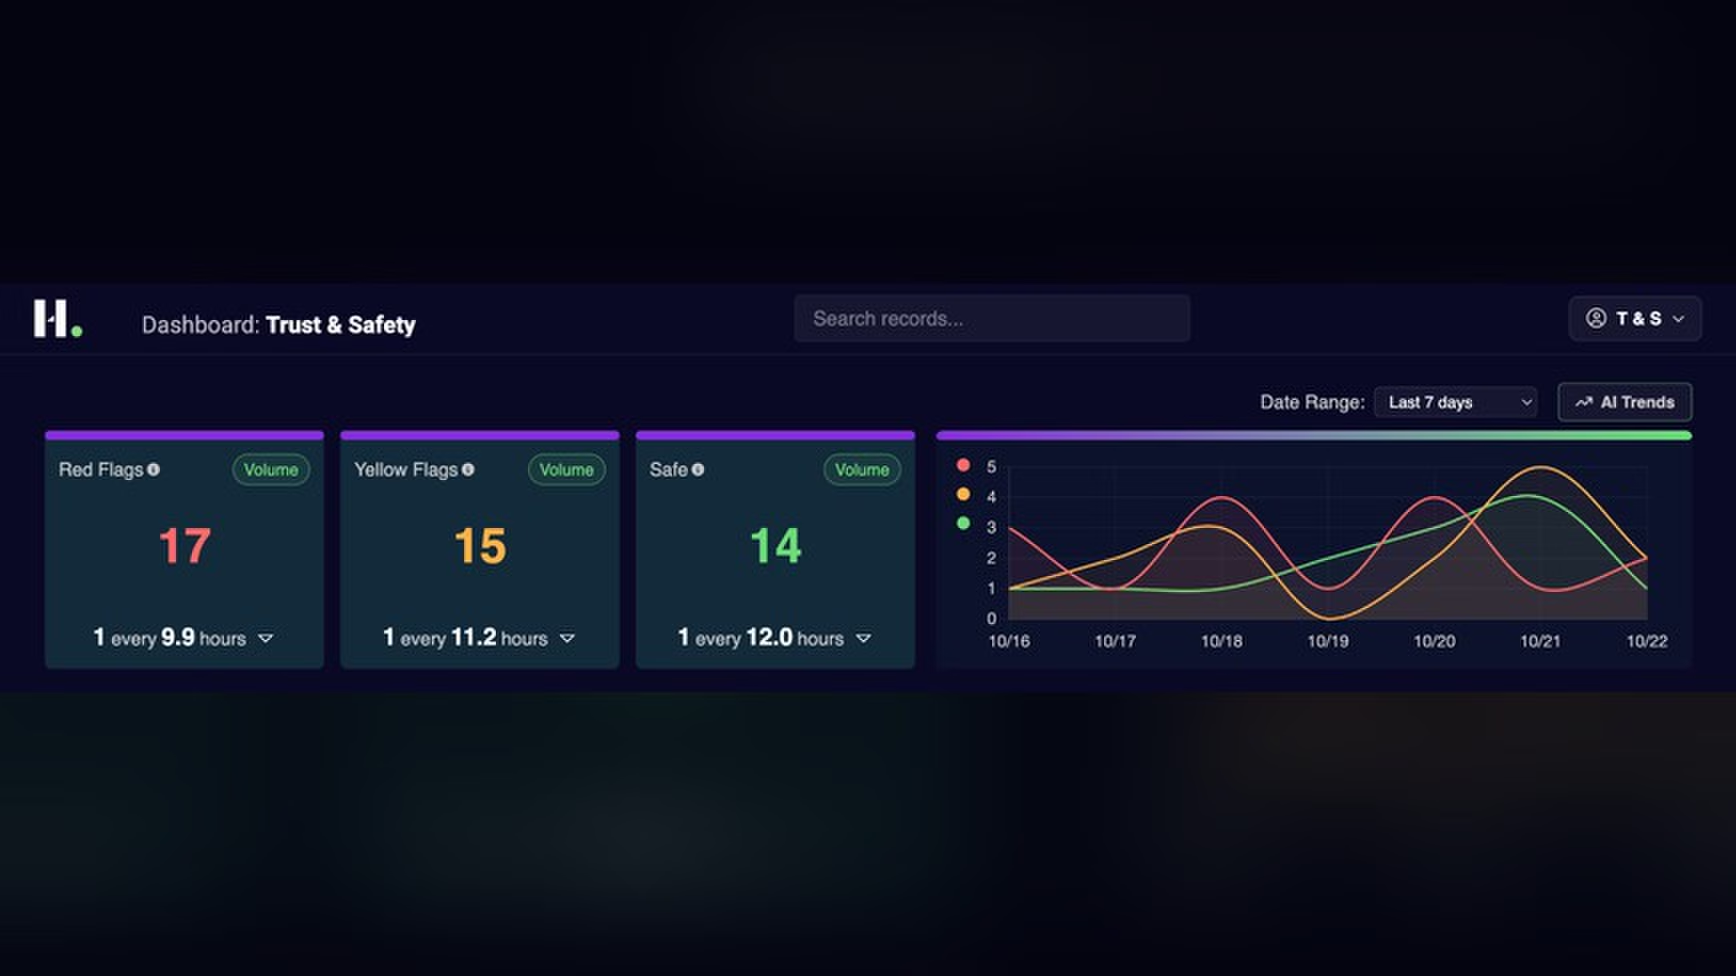
A moderação de conteúdo de IA empresarial costuma ser vendida como um centro de custo. Reduz o risco, mas poucos fornecedores garantem resultados. A retrospectiva mudou isso. Se seu modelo marcar uma postagem como “segura” e essa postagem levar a um incidente de responsabilidade documentado, os clientes receberão até US$ 1 milhão em apoio financeiro em vez de um pedido de desculpas e um patch.
Para equipes que enfrentam um prazo, a proposta real é simples. A substituição do Perspective exigiu apenas uma chamada de API e, em retrospectiva, capturou uma linguagem de codificação para a qual ferramentas semelhantes nunca haviam sido criadas.
A abordagem que Gebert sugere é executar tanto a retrospectiva quanto a perspectiva por uma semana e depois observar o delta onde eles discordam. Essas divergências sugerem que os escores de toxicidade por si só podem ser deficientes.
A Hindsight limita sua fila de lançamento a quatro clientes comerciais para permitir a calibração personalizada de instâncias de modelo com base nas políticas comunitárias e perfis de risco exclusivos de cada plataforma. O preço do fundador estará disponível para o primeiro grupo.
Para ingressar na lista de lançamento e testar retrospectivamente seus dados, visite https://hindsightAI.com.